前回は導入と試用までだったのですが、125Bの賢さと実用域の速度に驚かされ、それ以降も色々調べていました。今日はその後編となります。
「AI推論を爆速にするなら最新のハイエンドGPUとDDR5メモリが必須」——そんなローカルAI界隈の「常識」を真っ向から打ち破る事件が起きました。
手元のLGA2011-3 Xeon(8コア制限)+ DDR3デュアルチャネル 64GB + RTX 3060 12GBという、総額約6万円の型落ち・ジャンク構成環境にて、Strataの最新アップデート(v0.1.43)を適用したところ、Qwenベースの125B MoEモデル(IQ3_XXS)の生成速度がアベレージ40 tok/s、局所的には50 tok/sオーバーという異次元の速度に達しました。
今回は、今回のアップデート検証から得られた生のデータをもとに、Strataの裏で動いている動的パイプラインの仕組み、VRAMとメインRAMの本当の関係、そして今後のローカルAIの進化予測について深く考察・解説します。
1. 検証環境と驚愕のベンチマーク結果
まずは今回の検証環境です。
- CPU: Intel Xeon E5-2678 v3(TurboBoostアンロックからのVRM保護のため8コアに制限)
- RAM: DDR3 16GB 四枚 64GB(クアッドではなくデュアルチャネル)
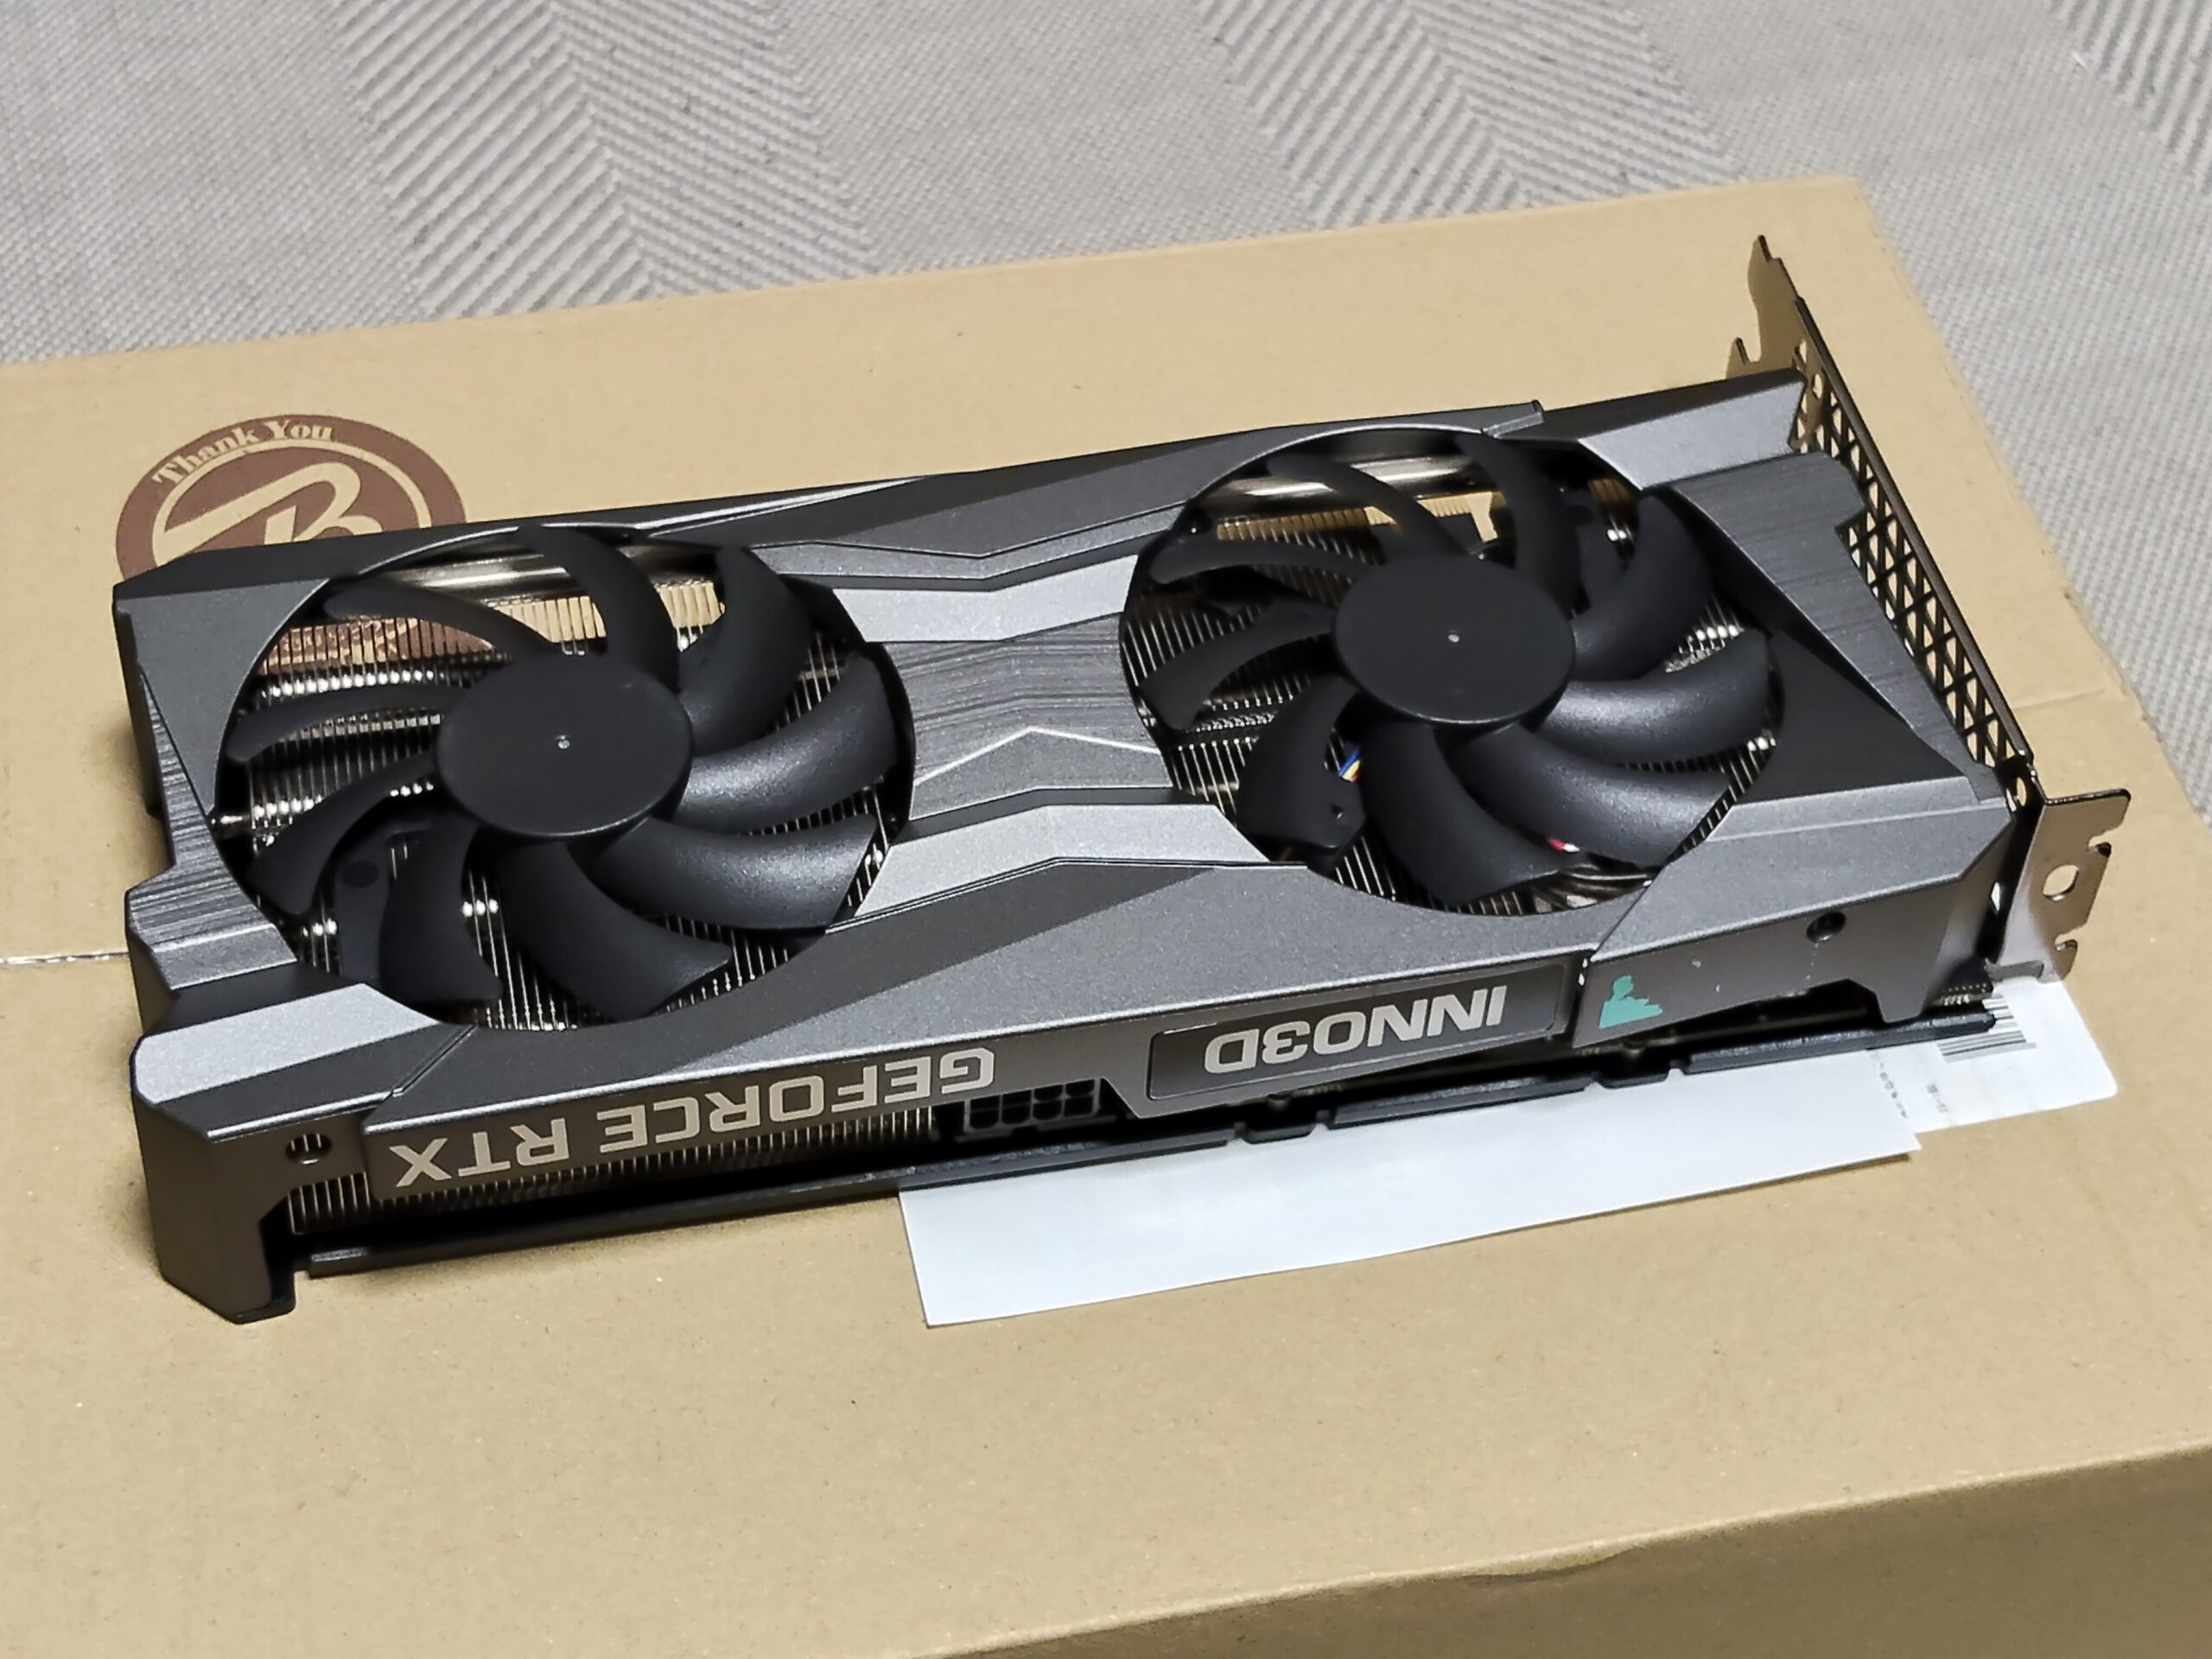
- GPU: NVIDIA GeForce RTX 3060 12GB(VRAM帯域: 360 GB/s)(電力69%の100Wに制限)
- Model: Qwenベース 125B MoE(IQ3_XXS / 3bit相当)
- Engine: Strata v0.1.43
速度の変化(アプデ前後)
- 従来(v0.1.38付近): 28 〜 29 tok/s
- 今回(v0.1.43): 平均 40 tok/s(瞬間最高 50 tok/s 超)
設定もモデルも一切変えず、推論エンジン(Strata)のみをアップデートしただけで約+30%〜40%の大幅な速度向上を記録しました。32kのコンテキストを読み込ませて長文のキャッチボールを繰り返しても速度が落ち込まず、非常にスムーズにレスポンスが返ってきます。
ここで気が付いたのは、いきなり平均 40 tok/s、が出たわけではなく、3,4回の会話を行った後にその数字に落ち着いたというところです。明確に学習がされています。
2. なぜDDR3デュアル環境で125Bが爆走するのか?(技術的考察)
通常、125Bクラスの巨大モデルをVRAM 12GBに載せようとすると、VRAMに入り切らない大量のパラメータがメインRAM(DRAM)へあふれ出します。どのAIに相談してもDDR3の20GB/s程度ではボトルネックにより悲惨な遅さになると言われます。
そして、物理的な転送帯域を見ると以下の通りです。
- RTX 3060 VRAM(GDDR6): 360 GB/s
- 最新 DDR5(デュアル): 約 80〜90 GB/s
- 型落ち DDR3(デュアル): 約 20〜25 GB/s
現実にはそんなに数字ほど何倍も遅いわけでなかったのです。そこで私が思ったのは、「VRAMの360 GB/sから見れば、DDR5だろうがDDR3だろうが等しくノロノロの亀である」というのが物理的な現実です。で、なぜDDR3環境でここまでの速度が出るのでしょうか?
① セットアップ時の「帯域計測」による動的アクセス制御
Strataのセットアッププロセスでは、初回起動時にシステム環境のメモリ転送速度を精密に計測しています。 これは単なる動作確認ではなく、「この環境のメインRAM帯域(DDR3デュアル=約20GB/s)のボトルネック」をソフトウェア自身が正確に把握する作業です。帯域の細さを事前に理解しているからこそ、メインRAMへのアクセス頻度を極限まで減らし、VRAMとMTP(Multi-Token Prediction:先読み演算)へ処理を逃がす動的最適化が機能しています。
② ヒット率に基づくエキスパートの動的パージ(追い出し)
MoE(Mixture of Experts)構造において、全125Bのうち実際に毎トークン動くのは一部のエキストラ層です。 Strataは、ルーター(Gating Network)の呼び出し履歴から「直近でヒット率(使用頻度)が低下したエキスパート」を即座にVRAMからパージ(排除)し、メインRAM側の退避エリアへ追いやります。空いたVRAMの特等席には次に頻出するエキスパートを配置するため、DDR3の遅いバス帯域が足取りを狂わせるのを最小限に抑えています。
3. コミュニティの検証データ(9070 XT環境との比較)で見えた「上限」
ネット上のコミュニティ(X等の投稿)では、Radeonの最新カード「RX 9070 XT 16GB」や最新CPU(Core i7-13700K + DDR5 96GB)を用いたStrata(および派生フォーク)の検証報告も見られます。
- 13700K + DDR5 + RX 9070 XT (16GB): 約 60 tok/s
- 私の6万円 Xeon + DDR3 + RTX 3060 (12GB): 約 40 tok/s
※AMDもRDNA4の環境では今回のアップデートで+38%だったかの爆速になっています。
最新の数十万円環境であっても、着地点は60 tok/s 前後に収束しています。 これは、Strataが「12GB〜16GBのVRAM帯で125Bモデルをいかに破綻なく動かすか」に焦点を当ててミリ単位のチューニングを施している証拠です。
40 tok/sと60 tok/sでは、画面上の体感速度の差はわずかです。つまり、「無理に大金を投じて最新CPUやDDR5環境を揃えなくても、6万円の型落ちジャンク構成で十分に実用最高峰のパフォーマンスが得られる」という、究極のコスパの構図が証明されたと言えます。
4. 今後のローカルAI・推論エンジンの進化予測
今回の検証とStrataの設計思想から、今後のローカルAI環境について以下の3つの予測が立てられます。
① 「VRAM容量頼み」から「スマート・ストリーミング」へのシフト
これまでは「VRAMに入らないならグラボを増設する・買い替える」というハード依存の解決法が主流でした。今後はStrataのように「メインRAMを単なる予備スタック(退避場所)と割り切り、アルゴリズム側でバス遅延を隠蔽する」設計が標準化していくと考えられます。
② 200B超え巨大モデルへのターゲット拡大
現在12GB〜16GB帯で125Bモデルの最適化が完成しつつあるため、次のステップとして「RTX 4090/5090(24GB〜32GB VRAM)環境に向けた200B超えモデル(DeepSeekやQwenの大型MoE)の超高速オフロード最適化」が進む可能性があります。24GB VRAMで超巨大モデルが、50〜70 tok/s以上でぬるぬる動く未来も遠くありません。
③ 「CUDA一強」からの脱却とマルチプラットフォーム化
Strataのアップデート履歴を見ても分かる通り、AMD(RDNA4/ROCm)やVulkanへの最適化が急速に進んでいます。これにより、「AI=NVIDIA一択」という固定観念が崩れ、Radeonの16GB/24GBカードがローカルAIの強力な選択肢として台頭してくるでしょう。このRDNA4がAMDのAI元年になるかもしれませんね。私も製品としての完成度は十分に高いと信じています。
まとめ:知識とロジックで型落ちハードを覚醒させる醍醐味
今回のStrata v0.1.43の検証を通じて分かったのは、「ハードウェアのボトルネックを正しく理解し、ソフトウェアの制御ロジックと噛み合わせれば、数年前の型落ちパーツでも最新環境に迫る性能を引き出せる」という自作PC本来の面白さでした。
- VRAM 12GB以上
- メインRAM 64GB
この2点さえ押さえておけば、6万円前後の型落ちXeon・DDR3環境であっても「125Bの知能を40 tok/sで常用する」という最高のローカルAI環境が手に入ります。
あ、Xeonでも、V2,V1の場合ですが、今まではAVX2が非対応だったことから蚊帳の外だったのですが、バージョン0.1.38だったかで互換性が持たれました。もちろんAVX2がないことから速度は残念かもしれませれんが、今はエラーではじかれることもなく起動させられるそうです。
手元に眠っているパーツやジャンクPCがある方は、ぜひStrataでの限界突破実験に挑戦してみてはいかがでしょうか!
\ 最新情報をチェック /


コメント